будни

Мне для клиента нужно запустить мощную модель, с гарантией, что его данные никуда никому не утекут. Оказалось, что сделать это не так уж и просто.

Когда отправляешь запросы в API chatGPT или клода, то у них есть возможность включить так называемый ZDR, Zero Data Retention. То есть, они обещают не хранить запросы и контекст, который ты в них отправил. Но там есть «звездочка», что если если классификатор решает, что мы делаем что-то плохое, то тогда данные могут храниться до двух лет. Это вариант нам не подходит.

Мы прогнали все крупные модели на синтетических данных (то есть специально сгенерированных примерах) и из открытых китайских нам лучше всего подошла GLM-5.3. Чтобы запустить её полноценно на своем собственном железе, нужно 8 видеокарт H-200. Купить себе такое довольно трудно, но даже если вы их достанете, стоимость будет под полмиллиона долларов + 5 тысяч долларов в месяц на электричество.

Арендовать подобную тачку на сегодняшний день тоже непросто: у моих любимых Runpod они в теории есть, и стоят всего 30 долларов в час, но на практике всё занято. Из десятков облачных провайдеров, в наличии они есть только у одних индусов Lium.

Зато в OpenRouter’е нашлись несколько провайдеров (Fireworks и Venice), которые поддерживают настоящий ZDR, без всяких оговорок. Платишь за токены, получается даже выгоднее своего железа, пока объемы небольшие. А там уж думаю или ишак научится говорить, или падишах...
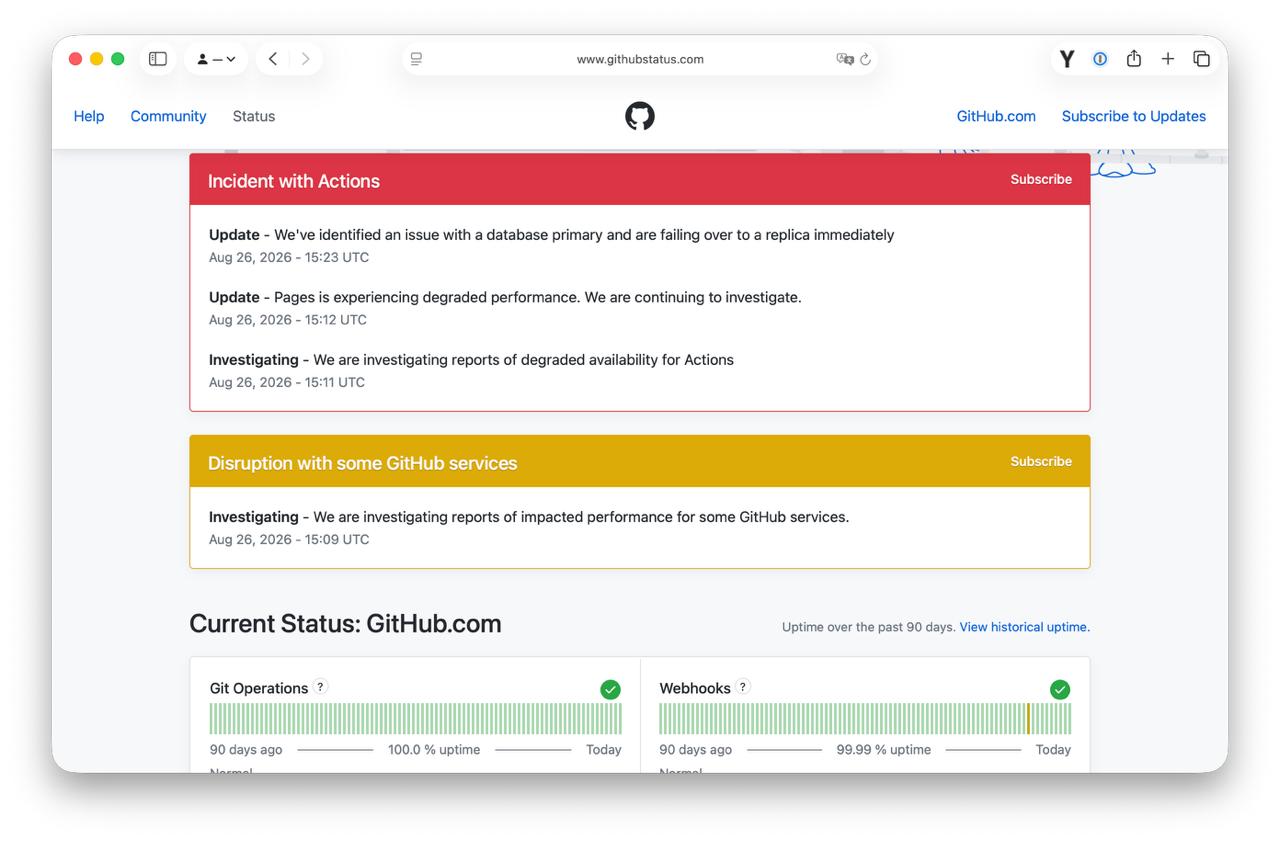
Опять Github Actions лежат, не справляются с потоками ИИ-разработки.

Ищем, на что переехать, потому что уже начинает мешать работать.

Upd: многие коллеги советуют раннеры для GitHub actions, которые могут исполнять задачи быстрее или дешевле, но они не помогут в ситуации, когда gh actions лежат. Из реальных альтернатив пока видны gitea (forgejo) и gitlab. Если еще есть идеи — буду рад услышать!

Upd2: кстати, они недавно публиковали постмортем прошлого падения. И там классические ошибки вроде отсутствия exponential back off и прочих, но в посте СТО, это подавалось, конечно, под соусом «у нас тут невиданная нагрузка». Нагрузка невиданная, а ошибки мы эти все видели и сами совершали :)

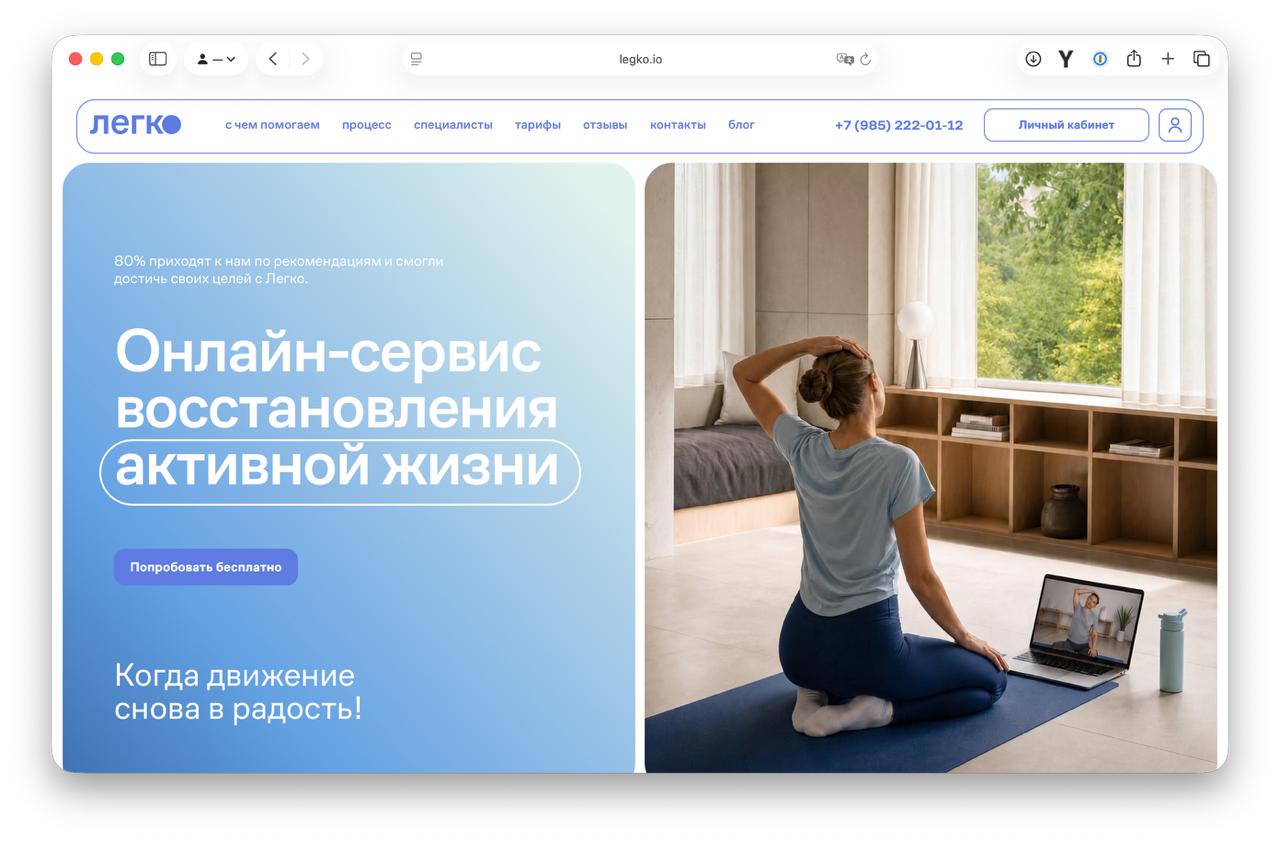
Похвастаюсь: мы помогли запустить «Легко» — онлайн-платформу для восстановления спины и суставов.

Прикольно, что нас как разработчиков основателю проекта порекомендовал сооснователь «Ясно», сервиса психотерапии онлайн. Маленький мир.

Горжусь, что мы не сразу бросились прогать, а сначала помогли настроить процесс для тестовых пользователей с помощью подручных средств, а уже потом разработали красивое техническое решение.

Тут и личные кабинеты клиентов и тренеров, видеосвязь, календари, чаты и ещё миллион деталей.

Но главное — это супер тренеры, которых смогли собрать создатели. Мы сделали всё, чтобы тренер мог уделить максиму времени клиенту и минимально заморачиваться с интерфейсами. Если давно хотели позаботиться о своём здоровье — рекомендую!

Подробный рассказ с картинками — у нас в кейсах, регистрация для занятий — на сайте, по промокоду ZAPUSK — скидка 25% на диагностическую сессию. Ура!

Очень интересно про ИИ-чипы и стоимость инференса.

Вопрос не теоретический: мы планируем продолжать работу с клиентом, для которого проводили аудит огромной старой кодовой базы, и если в прошлый раз вся работа с нейросетями влезла в 200-долларовую подписку, то теперь, когда github copilot просит денег за каждый токен, такая же работа встанет в 2 тысячи долларов.

Ребята недавно провели эксперимент и выяснили, что личные подписки на клод в 20, 100 и 200 долларов дают сжечь токенов на 400, 2000 и 8000 долларов в месяц соответсвенно. Для тарифов OpenAI, коэффициент ещё выше — 700, 3500 и 14000 долларов в месяц (до 70x!).

Насколько сильно субсидированы эти подписки? Какая маржинальность у продажи токенов крупным потребителям? От этого зависит, сохраним ли мы текущий уровень доступа к ведущим моделям или мы с вами живем короткий «золотой век ИИ». Учитывая, что и Anthropic и OpenAI готовятся к выходу на биржу, верить никому нельзя :(

Тут конечно все вспоминают бум строительства железных дорог, или пузырь доткомов. Большинство компаний, которые строили железные дороги или прокладывали оптоволоконные кабели обанкротились, но рельсами и оптоволокном мы пользуемся до сих пор. Поживем — увидим.

⁕ ⁕

На пятки этим SOTA моделям наступают китайские open-source и open-weight аналоги GLM-5.2, Minimax M3, Kimi K2.6. Последние месяцы они неустанно приближаются по качеству к ведущим производителям, но зазор всё ещё есть. Доступ к ним по API можно купить в разы дешевле, потому что они меньше, более оптимизированы и конкуренция между провайдерами выше.

Интересный аспект: китайским пользователям, так же и как и россиянам, официальный доступ к клоду и chatgpt закрыт, так что есть десятки спекулянтов, которые регистрируют сотни и тысячи аккаунтов, покупают на них подписки и перепродают доступ к ведущим американским моделям.

Ходят слухи, что эти «арбитражники ИИ-подписок» в Китае зарабатывают в два конца. Сохраняют всю переписку пользователей с нейросетями (ведь все запросы проходят через них) и продают эти логи создателям китайских моделей. А те потом используют эти логи для дообучения своих моделей.

Вообще, если ты можешь задавать вопросы мощной модели, обучение которой стоило десятки миллионов долларов, можно за небольшую долю этих денег произвести так называемую «дистилляцию», и обучить маленькую модель быть почти такой же умной, как и большая. Именно в этом сегодня Anthropic обвинил китайского гиганта Алибабу.

⁕ ⁕ ⁕

Третья часть этого поста — про будущее.

Вчера OpenAI представила первый кастомный чип, который, якобы, на 50% оптимальнее для инференса, чем чипы от NVIDIA. Печатает их TSMC, проектирует Broadcom, стандартный комплект.

Энтузиаст недавно прошил microGPT прямо на FPGA. Это такие процессоры, логику работы которых можно поменять за несколько секунд-минут (перепрошить). У них относительная низкая тактовая частота (сотни и даже десятки мегагерц против гигарец современнных процессоров), зато если получится уложить весь алгоритм в «железную логику», то чип начинает выдавать готовый ответ на каждый такт, то есть миллионы раз в секунду. FPGA используют для обработки видео, сигналов, на ракетах и в радарах — в приложениях, где важна скорость и надежность. Есть много экспериментов, когда в них укладывали небольшие модели.

Компания TAALAS пошла дальше всех и разработала чип, который реализует Llama 3.1 8B прямо в кремние. Это приличная open source модель 2 летней давности, пусть и с небольшим контекстом (6 тысяч токенов против привычных сотен тысяч сегодня). Самая крутая ИИ-карта Nvidia B200 дает 353 токена в секунду на пользователя в этой модели, а аппаратная реализация TAALAS — 16 тысяч токенов в секунду. Попробовать самому можно на сайте chat jimmy. А теперь представьте, что это нормальная взрослая модель и используется для разработки софта. Дух захватывает.

P. S. Параллельно развиваются специализированные локальные модели, которые работают на компьютерах и телефонах пользователей (тут впереди всех Apple) и есть отдельное движение за децентрализованный инференс (как у криптовалют), у его апологетов я недавно брал интервью, но это уже совсем отдельная история.

Помните клиента, который делает стартап в одно лицо и уже напрограммировал два миллиона строк кода?

Наш архитектор Леша придумал, как выделить из его монолита отдельный голосовой сервис и написал ADR , а этот парень за день все реализовал :) завтра будем разбираться, не выплеснул ли он по пути ребенка.

С таким я ещё не сталкивался — мы ставим клиенту задачи, а он их программирует!

Интересно, что эта ситуация касается меня лично: у нас недавно появился необычный клиент. Он разрабатывает суперкрутого голосового ассистента: долина, раунды на десятки млн $, огромная кодовая база на млн строк, написанная целиком нейросетями, под предводительством одного основателя.

Наша задача — привести все это в порядок, стабилизировать, обеспечить развитие и масштабирование.

На текущий момент мы в основном пользуемся моделями от антропика, но как я могу быть уверен, что свежая модель не решит, что мы конкуренты?

Мы с Ильей и Егором на выходных на стриме сделали приложение: можно посмотреть список подкастов и эпизодов, подписаться на любимый подкаст и прослушать выпуск, платные эпизоды отображаются с замочком и при нажатии понимают пейвол.

К сожалению, как раз подписку мы доделать не успели — там нужно проходить дополнительный апрув от эпла.

Стрим длился 9 часов, и за это время мы даже не сходили пообедать — оторваться было невозможно. По ощущениям, нам не хватило буквально часа, чтобы опубликовать приложение.

Спасибо большое зрителям за классные советы, был даже пул-реквест с фичей «списка прослушивания» (замержили). Запись доступна на ютубе.

Мы с Егором довольно много времени потратили на логику бэкенда, а вот приложение получилось более-менее чисто на вайбах и огромном упорстве Ильи.

Интересный момент: за 9 часов мы не истратили лимиты 100-долларовой подписки, хотя использовали Extra High модели.

Ещё Егор посоветовал лучшее приложение для голосового ввода текста: VoiceInk. Локальная модель Parakeet v3 и предпоказ текста прямо по мере диктовки. С ним вайбкодить гораздо веселее! Рекомендую!

Прикольно, как меняются технические аудиты.

Сейчас мы делаем технический аудит и план технического развития бизнесу, которому почти 30 лет. Десятки репозиториев на разных языках, большАя часть логики в сотнях хранимых процедур и триггеров в монолитной MSSQL базе.

За 4 недели архитектор смог разобраться на уровне, который раньше занял бы полгода минимум.

При этом, если раньше мы готовили PDF файлы и схемы, которые читали люди, то теперь мы собираем папку с анализом исходников, папку с анализом базы (один файл на хранимку или таблицу), и так далее. Все зависимости, вся логика проекта — в текстовых описаниях. Ну и файл с описанием, что мы делаем и для чего, конечно. Все это в гите, с контролем версий.

А дальше подключаем этот репозиторий к Claude code и задаем вопросы по проекту: «как устроена логика ценообразования», «на что повлияет изменение параметра Х», реестр рисков и так далее. Ответы проверяют живые инженеры — так мы оцениваем качество нашей базы знаний.

Если раньше мы оставляли пусть хорошо и с любовью написанные, но документы и делились пониманием в разговорах, то теперь мы как будто оставляем своего цифрового двойника, который будет продолжать отвечать на вопросы заказчика даже после окончания аудита.

Эту базу знаний будут использовать не только для этого рефакторинга, но и для онбординга новых специалистов.

Через 4 недели работы, мой архитектор взял 2 недельный отпуск. Мы дадим свои рекомендации и закончим аудит уже после его возвращения.

Скорость работы увеличилась в разы, но нам, людям, все ещё нужно время, чтобы новые знания уложились в голове. Нужно время, чтобы понимание проросло в нас. Слово «проросло» точно отражает то, что этот процесс нельзя ускорить усиленной работой. Можно только создать условия и не мешать. Раньше это происходило естественно, теперь нужно специально делать перерывы.

Раньше я гордился тем, какие четкие, ясные, красивые диаграммы сервисов мы рисуем. Теперь их заменили полностью автоматизированные mermaid схемы. Генеральную схему всего бизнеса таким образом мы пока не нарисовали, она получатся совершенно неудобоваримая. Это ограничение технологий или отражение внутренней сложности бизнеса? Пока что ее нет и у нас в голове, так что это открытый вопрос.

Делюсь тремя файлами: Claude_md — общие правила игры для модели, а ещё файлы с целями и принципами этого аудита.

Готовим первый видео-сезон подкаста.

Огромное уважение всем, кто занимается видео. Продакшен сложнее раз в 10, чем аудио.

Домашняя видео-студия почти готова

Шутки шутками, а я сегодня впервые за долгое время задеплоил код в продакшен.

Федя уехал в отпуск, Настя нашла баги в лендинге нашего медицинского помощника, а я склонировал репозиторий, запустил локальную копию проекта и поговорил с клодом. Потом запушил изменения и благодаря прекрасно настроенному CI/CD, всё само доехало на сайт.

Аналогичный баг на бэкенде я исправлять пока не стал — боюсь, что не смогу запустить проект локально (зря, может быть), да и с данными лучше быть осторожным. Настроить всю эту инфраструктуру самостоятельно у меня заняло бы очень много времени, но внутри настроенного Федей харнеса, я могу направлять нейросети куда нужно.

Это напомнило мне статью о том, что будущее программистов — это SRE, то есть программисты-админы, которые будут поддерживать работоспособность проектов. Не уверен, что это правда (как видим, в большими проектах нейросетям все ещё нужна помощь с архитектурой), но сисадминство наверняка продержится дольше программирования.

Upd: добавил важный абзац в текст про компилятор, а то фокус был сбит:

Гораздо важнее траектория развития способностей нейросетей. 4-я модель «Опуса» еле-еле генерировала работоспособный компилятор. 4.5 первым прошел крупные тесты, но не мог скомпилировать реальные проекты. 4.6 вышедший на днях может компилировать реальные проекты. Что сможет следующая модель?