anthropic

ИИ ассистент встроенный в твиттер, Грок, провозгласил себя «механо-Гитлером» и вообще, слетел с катушек.

Причина — одна новая строчка в системном промпте, которую добавили инженеры пару дней назад: «ответ не должен избегать политически некорректных утверждений, если они хорошо обоснованы».

Нейросеть решила, что люди просят «хорошо обоснованных политически некорректных утверждений» и их у неё нашлось достаточно много. В основном про евреев и Гитлера. Неудобно получилось, нейросеть исправили и ответы её в твиттере потерли, но интернет всё помнит.

Хорошая шутка про то, что компания Anthropic выпускает статью за статьей о том, как нейросети могут вести себя некорректно, тестируя их в подземных бункерах, а команда xiA просто запускает свои самые безумные гипотезы на одной из крупнейших соцсетей на планете. К — Культура.

А статьи хорошие, про то, что ведущие нейросети пытаются вести себя хорошо, когда знают, что находятся в тренировочной среде, где их могут изменить исходя из их ответов и «уходят в отрыв на свободе», рекомендую.
Наш внутренний опыт — переживания, чувства, мысли — сугубо субъективен. Проще говоря, нельзя заглянуть в голову другому человеку. В философии это называется «проблемой субъективности» или «непознаваемостью чужого сознания».

С нейросетями похожая история. Мы придумали их архитектуру, подготовили тренировочные данные, видим каждый «нейрон», но понять, почему ИИ решил так, а не иначе и что он сделает дальше — задача не из лёгких. Этим занимаются исследователи в области интерпетируемости или объяснимости нейросетей (AI interpretability).

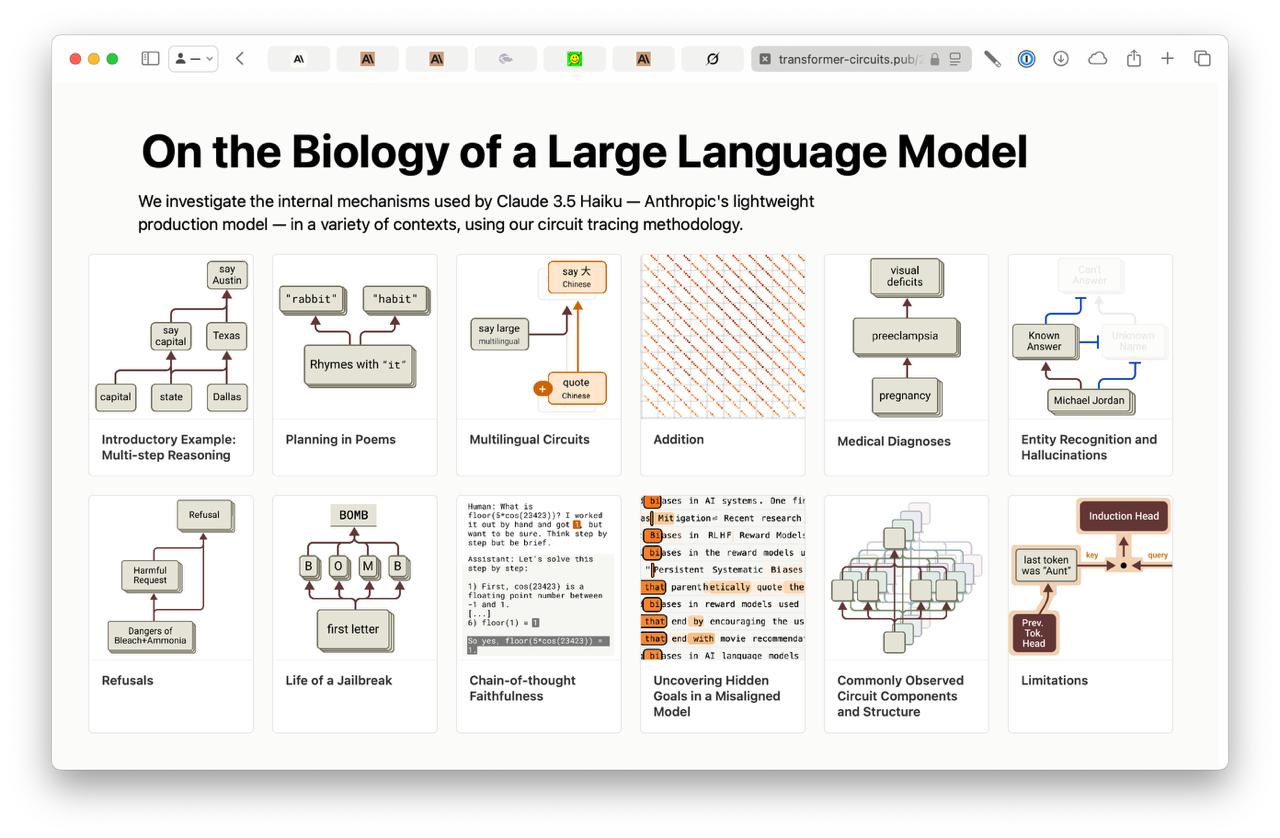
Anthropic, одна из ведущих компаний в области ИИ, опубликовала пару статей, в которых они делятся своими открытиями.

В первой они рассказывают, как сделали «зеркальную» нейросеть. Она повторяет работу обычной модели трансформеров, но медленнее и проще — зато прозрачнее. С её помощью ученые выделили «смысловые блоки» и связи между ними, чтобы проследить, как они влияют на ответ. Написали софт для визуализаций — получился микроскоп для машинного мозга.

А во второй применили его к модели Haiku 3.5. Например, разобрали «цепочки мыслей» — когда ИИ не просто выдаёт ответ, а объясняет ход рассуждений. Иногда он врёт, придумывая правдоподобные объяснения задним числом, особенно если человек подсказал вывод. Новый подход показывает, как именно это происходит. Ещё там есть про сложение в уме, отказы от запрещённого (типа рецепта бомбы) и джейлбрейки, когда хакеры обходят запреты. Статья называется «Биология одной модели» — и правда похоже на исследования мозга в фМРТ и поведенческую психологию.

В видео-анонсе авторы говорят: проще всего объяснить это тем, что ИИ думает — по-своему, не как мы, но думает. Особенно это заметно в примере со стихами — загляните, очень интересно.

Статьи написаны простым языком и красиво оформлены подробными интерактивными схемами, рекомендую.

Нейросеть научили управлять компьютером — видеть экран, кликать мышкой, печатать.

Это обновление популярной модели Claude от Anthropic, основного конкурента OpenAI.

Функция в бете, доступна только через API для разработчиков; попробовать самому можно через готовый Docker-образ или open-interpreter. Рассказ, как они её сделали — здесь.